Начинаем с описания предметной области
Для того, чтобы описать предметную область и иметь возможность формально обрабатывать это описание с помощью существующих технологий, нужен язык описания именно предметных областей. Проблема современных УЯП в том, что они слишком универсальны. Они обслуживают универсальные парадигмы, имеют алгоритмическую или другую семантику, не относящуюся прямо к семантике описания предметной области. Они прекрасно справляются со связыванием компонентов, что безусловно полезно, но слишком избыточно.
Позже мы вернёмся к вопросу выбора семантики. Очевидно, выбор будет зависеть от конкретной предметной области, но точно не от инфраструктуры и архитектуры программного обеспечения (ПО) и не от наличия на рынке программистов на конкретном УЯП!
После выбора семантики описания предметной области можно определить синтаксис, который наилучшим образом её отражает. В итоге получится язык, который можно условно назвать Domain Driven Language (DDL). Далее будет приведён пример кода на этом языке. Но сначала давайте посмотрим, как это может работать.
На рисунке 1 приведена условная схема формирования информационной системы (ИС) на базе описания предметной области с использованием DDL.

Рисунок 1. Схема формирования информационной системы из описания предметной области с использованием DDL
Условно названная «DevOps»-команда формирует компоненты архитектуры и инфраструктуры. Это сродни формированию библиотек компонент для различных сред работы приложения и в идеале может выполняться совершенного независимо от предметной области. Нужно лишь соблюдать соглашения о формате «чистой» семантики, не зная о её содержимом.
Можно видеть, что при такой схеме работы не столь важно в какую архитектурную и инфраструктурную среду мы помещаем автоматизацию предметной области. Вся эта машинерия, как и положено, находится под капотом. В результате может формироваться микросервисная архитектура с использованием заранее заготовленных компонентов и фреймворков для браузерного или мобильного UI. А может – монолит настольного приложения в архитектуре махрового клиент-сервера. Да что угодно! И даже всё вместе! При одном и том же описании предметной области.
Обзор предметной области для разработки мобильных приложений
В XXI веке трудно представить себе человека, который не имеет представления о смартфоне или планшете. Эти девайсы глубоко укоренились в нашей жизни, что не представляется жизнь без них. Кто-то использует их для работы, кто-то для учебы, развлечений и т. д. И как трудно бывает в ситуации, когда девайс забыт дома. Появляется такое чувство, будто выбит из колеи. Поскольку данные устройства всегда и повсюду с нами, а также в силу большого прогресса развития в науке, они помогут заменить человеку целые вычислительные станции, которые не нужно никуда транспортировать, ведь эти устройства всегда под рукой.
На данный момент ведущие компании стараются удержать первенство по созданию приложений для упрощения нашей повседневной жизни, в том числе сферы планирования. В результате проведенного анализа подобных приложений помощников в сфере планирования стало очевидно, что разработка открытого русскоязычного бесплатного приложения, позволяющего планировать расписание учебных занятий, которое обратит внимание на целесообразность в установке в приложение сгруппированного списка контактов преподавателей, а также составление заметок.
Цель: изучить спрос продукции, представленной в мире, среди электронных устройств.
Мировая аналитика спроса на электронные устройства
Изображение 1 – Количество устройств в мире по результатам аналитики Gartner
Классификация по операционным системам мобильных устройств (смартфонов)
Изображение 2 – Аналитика операционных систем
для смартфонов в РФ по версии StatCounter
Язык разработки Android-приложения
Какие существуют языки программирования для Android-приложения:
Выбор языка остановлен на Kotlin, поскольку это статически-типизированный, объектно-ориентированный язык программирования. Среди его достоинств создатели отмечают прагматичность и гибкость. Язык одинаково хорош как для начинающих программистов, так и опытных.
Среда разработки
Наиболее подходящим средством для разработки является Android Studio, поскольку данная среда разработки содержит встроенный эмулятор, который позволяет протестировать одно приложения сразу на нескольких устройствах разных версий операционной системы Android. Так же в эмуляторе, помимо разнообразия версий ОС Android, можно подбирать размер диагоналей экрана, что является несомненным плюсом при тонкой настройке разметки отображения внешнего вида приложения.
Вывод
Исходя из всего вышеперечисленного, можно сделать вывод об актуальности разработки приложений на смартфоны операционной системы Android на языке Kotlin в среде разработки Android Studio ввиду большого спроса и популярности в этом направлении, количества информации на эту тему и количества открытых библиотек.
Список литературы

Заключительным шагом реализации приложения является интеграция с внешними сервисами.
Этот этап состоит из 3 шагов:
Именно на этом этапе создаются / дополняются клиенты внешних интерфейсов. Именно на этом этапе создаются / дополняются их конфигурации.
Как мы можем заметить, шаги напоминают этапы 1-3 создания приложений, но в масштабе DAO.
Внешний интерфейс, будь то база данных, соседний микросервис в Вашем окружении или полностью сторонний сервис, живёт в своей предметной области. И первым нашим шагом будет создание этой предметной области в DAO – компоненте приложения, специально для этого предназначенном (более подробно о компоновке DAO можно прочитать в статье Луковичная архитектура в компоновке backend-приложения и куда в итоге класть маперы).
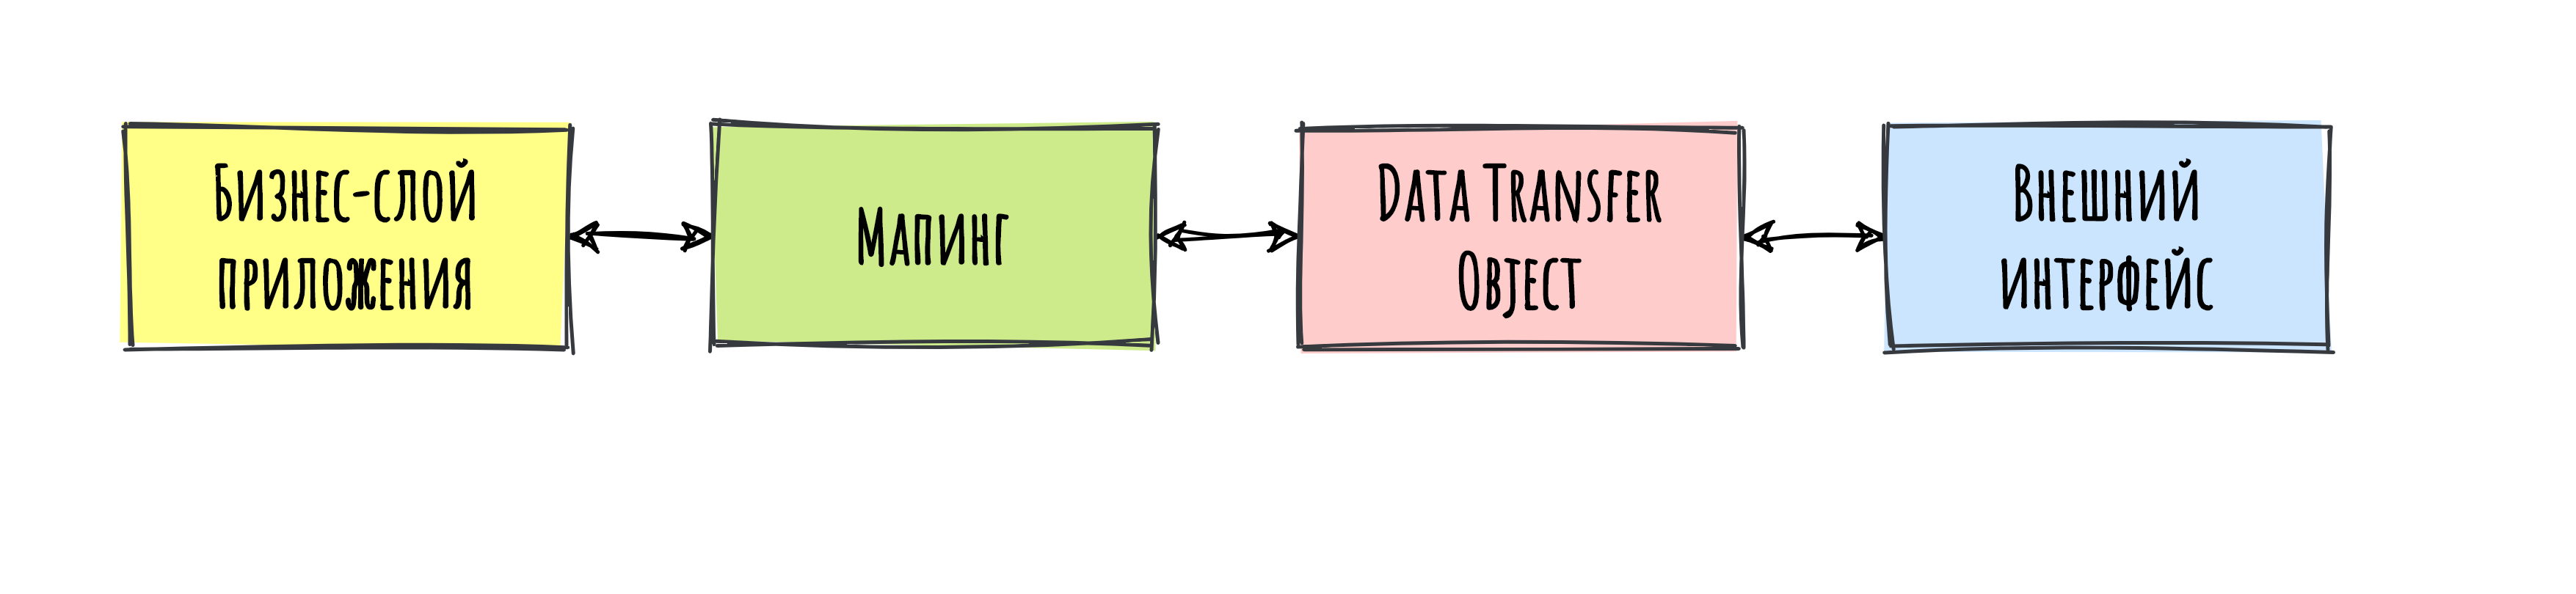
Классическая схема интеграции с внешним сервисом
Второй шаг – адаптация предметных областей – нашей и внешнего интерфейса. Мы пишем маперы трансформации из нашей предметной области в предметную область стороннего интерфейса и обратно.
Третий шаг – реализация интерфейсов. Этот шаг в точности повторяет третий этап реализации приложения: пишем интерфейс, покрываем тестом, пишем реализацию.
Но есть одно но.
Модульные тесты должны быть полностью изолированы. Иными словами, они должны одинаково хорошо выполняться на любом окружении. Но любой тест должен воспроизводить сценарий, максимально приближенный к реальному. Как быть с внешними интерфейсами? С одной стороны, мы не можем во время тестирование подключиться к внешнему сервису. С другой – мы не можем гарантировать, что наш SQL-скрипт, который мы вызвали, отработает корректно, пока не протестируем его.
Мы считаем, что изоляция тестов первична. Но в пределах изоляции мы стараемся протестировать всё, до чего можем дотянуться.
Существуют практики, позволяющие протестировать внешний интерфейс без нарушения изоляции тестирования. Наиболее распространённая из них – testcontainers, и мы с удовольствием ей пользуемся, когда хотим протестировать репозиторный слой. Во время тестирования в тестовом окружении поднимается контейнер с базой данных, приложение подключается к этой базе и отрабатывает скрипты “на живую”. Таким образом, мы точно можем быть уверены, что наши скрипты корректно работают.
Но интеграцию с условной дадатой мы протестировать не можем. Такова плата за изоляцию.
Проектирование логического скелета

Мы перешли к самому спорному шагу. Заставьте разработчиков писать интерфейсы, и вас возненавидят 8 из 10. Заставьте их объяснить, зачем нужны интерфейсы, и Вас возненавидят остальные двое.
Разработчики в своей массе не любят писать интерфейсы. Интерфейс в обычном понимании разработчика – это костылёк, позволяющий поддерживать несколько реализаций только там, где это необходимо. Да, отсутствие интерфейсов прямо противоречит принципам S. O. L. I. D, но когда это останавливало? Такой разработчик объяснит Вам, что “он пишет код, руководствуясь здравым смыслом” (но поскольку все мы считаем собственные решения здравыми, на самом деле, эта фраза звучит как “я пишу код так, как мне хочется”).
Интерфейсы – это важнейший элемент архитектуры. Интерфейсы обеспечивают приложению гибкость и изменяемость. Интерфейсы являются теми самыми стабильными компонентами, на которых держится приложение.
Когда дело касается проектов в материальном мире, мы понимаем, что детальное планирование, скажем, высотного дома, с соблюдением всех норм и технологий, просто необходимо. Достаточно один раз тщательно спроектировать постройку, и можно быть уверенным, что дом простоит в неизменном виде до скончания века.
Но, как мы знаем, в мире разработки всё не так. Продукт постоянно изменяется и развивается, многие функции приложения появляются, изменяются и исчезают. Приложение живёт. И нам, как разработчикам, необходимо заложить в приложение гибкость, которая позволит ему легко изменяться. Да, интерфейсы добавят приложению некоторую сложность. Но посмотрите на скелет человека. Вот кость. Она очень простая и прочная. Но она не сгибается, и мы ничего не можем с этим поделать. Две кости, соединённые суставом, легко сгибаются и могут принять разные формы. Да, такая конструкция уже сложнее, но это та цена, которую мы платим за гибкость и изменяемость системы.
Итак, на втором этапе мы пишем интерфейсы.
Первое, что мы делаем – назначаем каждой бизнес-сущности свой сервисный интерфейс, в котором мы спроектируем основные операции, проводимые с бизнес-сущностью и при помощи неё. Всё, что умеет сущность – она умеет в своём сервисе, и нигде более.
Часто приходится видеть сервисные функции, в которых то тут, то там происходят изменения со сторонними бизнес-сущностями. Это нарушает гибкость всего приложения.
Если Вам требуется совершить операции со сторонней сущностью, передайте её в её личный сервис и сделайте всё необходимое в нём. Все операции с бизнес-сущностью должны происходить в её личном сервисе. Точка.
Нужно руководствоваться принципом YAGNI – не проектировать ничего сверх того, что может потребоваться для работы с сущностью на первоначальном этапе. Но прежде чем мы опишем самые необходимые операции, нам нужно будет определить иерархию сервисов – чтобы потом придерживаться её на протяжении всей разработки.
Два сервиса не могут взаимно зависеть друг от друга.
Что это значит? Мы уже знаем, что если сервис А вызовет сервис Б, а сервис Б вызовет сервис А, это вызовет циркулярную зависимость. Но это не самое страшное. Циркулярная зависимость – это не более чем сигнал – в первую очередь, о том, что с Вашей архитектурой что-то не так. Именно поэтому на этапе проектирования нужно точно определить, как бизнес-сущности, а значит, и их сервисы, зависят друг от друга.
Зависеть – это значит, знать детали и иметь возможность влиять на компонент, от которого ты зависишь.
Посмотрим на наш интернет-магазин.
Начнём со связи “Покупатель – Корзина”. Знает ли покупатель детали своей корзины? Да, конечно. Он может зайти в неё и посмотреть, какие товары в ней лежат. Он может изменить её свойства – например, добавить или удалить товар. Знает ли корзина о своём покупателе? Нет. Она не может изменять свойства покупателя. Она ничего о нём не знает. Она просто знает, что неё есть какой-то покупатель, вот его id.
Знает ли товар про корзину, в которую он положен? Нет, он не знает, например, какие ещё товары хранятся в корзине, кто владелец корзины, и на какую сумму в ней сейчас лежит товаров. Корзина же знает про товар намного больше – стоимость, характеристики, фактического продавца – всё это пользователь, как правило, может видеть из корзины. Значит, корзина зависит от товара.
Составим блок-схему
Пробежавшись, таким образом, по всем сервисам, мы выстроим чёткое дерево зависимостей между ними:
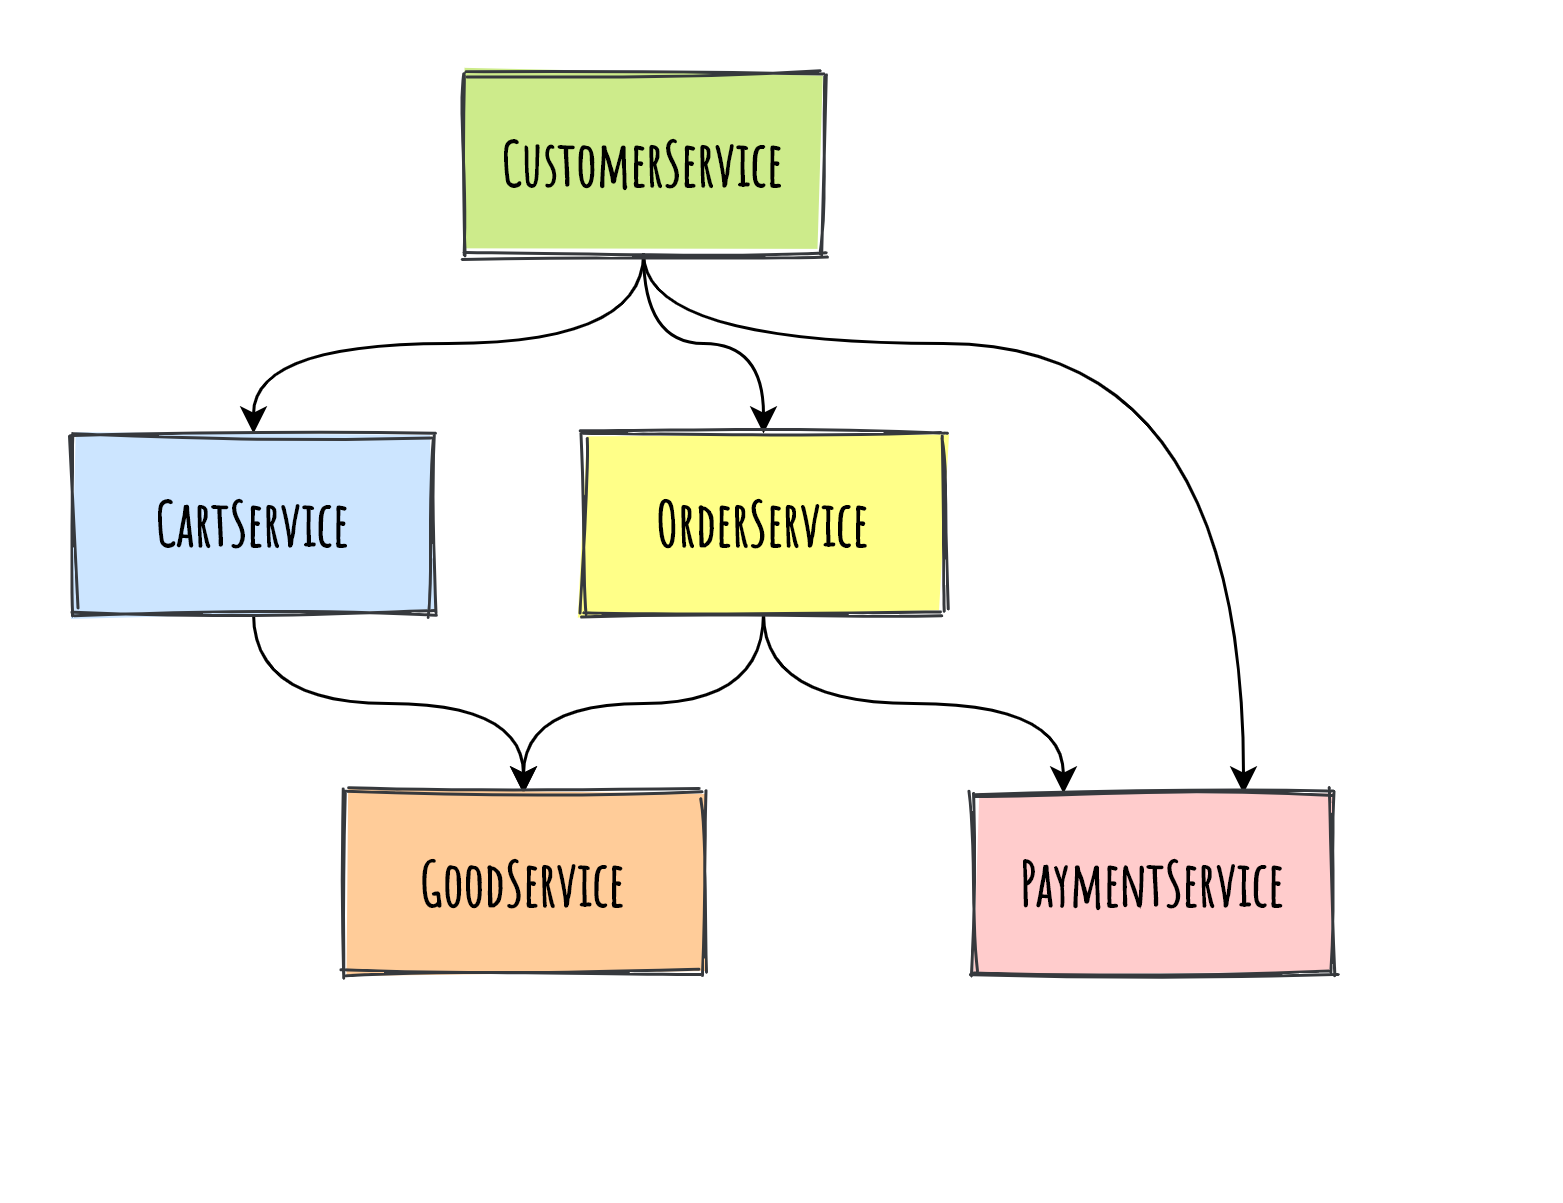
Упрощённая иерархия сервисов
Схема зависимостей, которую мы нарисовали – постоянна на протяжении всей разработки. GoodService больше никогда не сможет зависеть от CustomerService, а если так вышло – ищите, где Вы ошиблись.
Популярный пример: циркулярная зависимость. Вы понимаете, что CustomerService через OrderService зависит от GoodService. И вдруг Вам надо вызвать CustomerService из GoodService. Ну вот надо (чтобы получить Customer из базы данных, к примеру). Худшее решение (и, кстати, самое популярное) – вызвать CustomerRepository из GoodService.
Забудьте. Ищите, где Вы допустили архитектурную ошибку. И обязательно найдёте. Решение, скорее всего, Вам не понравится – цена архитектурной ошибки обычно очень высока. Но если Вы её нашли – Вы обязаны её исправить здесь и сейчас – если оставить всё как есть, дальше будет только хуже.
Бывает, что схема изначально была составлена неправильно – особенно, на первоначальном этапе разработки. В этом нет ничего страшного – скажите себе: “да, я облажался”, перепроектируйте схему и продолжайте её придерживаться.
Зафиксируем блок-схему в коде
После составления блок-схемы, мы фиксируем интерфейсы в коде. Здесь тоже нужно пользоваться принципом YAGNI. Мы не декларируем лишние функции. Мы декларируем только те функции, которые, на наш взгляд, нам точно потребуются. К примеру, мы не планируем удалять покупателей. Значит, в CustomerService не будет функции delete. То же касается и корзины – она существует до тех пор, пока существует пользователь. Также, мы не видим примеров, когда нам может потребоваться запросить корзину отдельно от пользователя. Значит, для корзины на данном этапе не требуется функция get.
У меня получилось спроектировать первоначальные возможности интерфейсов следующим образом:
Да, они получились довольно примитивными, как и наш пример в целом, но для данного поста пример вполне подходит.
По итогам второго этапа, мы получаем:
В дальнейшем, мы будем поддерживать эту блок-схему в актуальном состоянии. Она будет хорошим документом архитектуры приложения и поможет нам не запутаться в иерархии зависимостей.
Что же касается архитектуры приложения, то вот она вся:

По-прежнему, ничего лишнего. Бизнес-сущности, логический скелет. И мы по-прежнему не добавили ни одной зависимости в gradle.properties.
Имея схему и основанную на ней структуру интерфейсов, мы можем переходить к третьему этапу – реализации.
Этап 1C. Пишем код
После этапа визуализации мы описываем предметную область в коде.
Существует заблуждение, согласно которому, многие разработчики воспринимают данные из базы данных как первоисточник предметной области, и стараются в первую очередь запроектировать таблицы базы данных. Это неверное суждение. Бизнес-сущность должна быть описана в коде в виде data-классов.
База данных как внешний интерфейс лишь хранит состояние. И не более. На начало проекта Вы даже можете не быть уверены, какая именно база данных Вам подойдёт больше – реляционная, документоориентированная или графовая, например. Более точный ответ на этот вопрос Вы сможете дать только после детальной проработки бизнес-сущностей и связей между ними. Именно поэтому выбор базы данных следует отодвигать на самый последний, четвёртый, этап.
Помните: при проектировании бизнес-сущности первичен data-класс.
Связи вышеописанных бизнес-сущностей в коде будут выглядеть так:
Глаз цепляется за перекрёстные ссылки на классы выше по иерархии вместо ссылок на идентификаторы, что в перспективе грозит StackOverflowException при инициализации, но для наглядности связей такой пример подойдёт как нельзя лучше.
Итак, первый этап состоит из трёх последовательных шагов:
Только Вы, как разработчик, понимаете, когда следует заканчивать этап описания бизнес-сущностей и переходить к этапу описания поведения. На первом этапе, когда приложение только формируется, у Вас больше свободы, поскольку границы предметной области ограничены только Вашим пониманием её пределов. В дальнейшем, при реализации фич, Вы должны точно понимать, какие именно бизнес-сущности потребуются в рамках их решения.
Не задерживайтесь долго на этом этапе. Используйте итеративный подход. Если Вам кажется, что предметная область уже достаточно сформирована, переходите к следующему этапу. Пройдя весь цикл, Вы сможете опять вернуться к первому этапу и пройти цикл заново. Что Вы и будете делать при реализации каждой фичи, кстати.
Итак, что мы должны иметь после реализации первого этапа:
В итоге, у нас есть единственный пакет entity, в котором находятся бизнес-сущности. Вот как это выглядит в проекте:
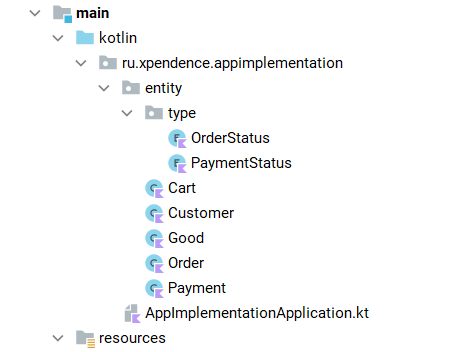
Лично я предпочитаю тёмную тему, но большие чёрные квадраты на белой странице смотрелись бы не очень.
На данный момент, в нашем проекте нет application.properties. Так и должно быть – нам пока нечего конфигурировать.
Я часто вижу проекты, на самом раннем этапе реализации которых разработчики стараются добавить как можно больше конфигураций – авось пригодятся потом. Чего там только не увидишь. Я даже молчу про драйверы базы данных и пути ко внешним сервисам – буквально на днях в одном из таких проектов я видел конфигурации кварца! Пакет main практически пустой, в предметной области не создано ни одного класса, но уже добавлены конфигурации кварца – авось в проекте будет кварц.
Добавление в проект избыточных конфигураций – это признак незрелости подхода к разработке. Конечно, код, изобилующий конфигурациями, кажется более весомым и создаёт впечатление чего-то стоящего. Появляется иллюзия большой проделанной работы. На самом же деле, избыточные конфигурации ничего не делают, и, возможно, вообще никогда не пригодятся.
Добавляйте конфигурации только тогда, когда им есть, что конфигурировать.
Итак, мы прошли все три шага, а значит, можно переходить к следующему этапу – проектированию логического скелета.
Другие семантики предметных областей и предметно-ориентированные языки
Ранее было замечено, что семантика DDD – одна из многих возможных и для каких-то областей может быть совершенно неприменима. В качестве примера можно привести предметную область имитационного моделирования динамических систем, где модели естественным образом записываются в виде систем обыкновенных дифференциальных уравнений. Для этой предметной области естественным будет описание модели на специализированном языке дифференциальных уравнений.
На рисунке 3 приведен скрин с описанием модели на языке дифференциальных уравнений, а также фрагмент описания запуска процесса моделирования на языке, являющимся базовым для других предметно-ориентированных языков (ПОЯ).

Рисунок3. Пример описания модели динамического объекта и запуска моделирования в интегрированной среде разработки системы SIMODO
Приведённый пример показывает, что можно использовать несколько языков, каждый из которых описывает свой участок предметной области. На рисунке 4 приведён фрагмент схемы из рисунка 1, который показывает более эффективное формирование модели предметной области, т.к. часть модели формируется специалистом собственноручно (безусловно, при этом может использоваться собственный ПОЯ, не обязательно только язык дифференциальных уравнений).

Рисунок 4. Применение ПОЯ при формировании модели предметной области
Таким образом, данный подход существенным образом привлекает специалиста предметной области к автоматизации своей работы, что ещё больше (по сравнению даже с Agile) увеличивает, как итеративность, так и качество процесса разработки.
Библиографические ссылки
Часть материалов и статей ещё не обработана или являются платными.
Рассмотрим простой пример

Рисунок 2. Пример описания агрегата «Заказ» на прототипе DDL в интегрированной среде разработки системы SIMODO
В приведённом примере значимые типы и атрибуты записываются на т.н. «общем языке» предметной области и могут автоматически формировать элементы UI и базы данных, что должно обеспечить пользователям знакомую среду работы.
Было бы крайне любопытно посмотреть на описание ваших предметных областей на этом языке, возможно, с использованием некоторых расширений (в виде модулей или дополнений в синтаксис языка), которые покажутся необходимыми. Это помогло бы в разработке языка. Можно предложить и свой синтаксис DDL.
Императив предметной области при разработке информационных систем
Время на прочтение

В настоящее время информационные технологии достигли высочайшей степени автоматизации разработки программного обеспечения. Мы умеем разрабатывать сложные распределённые приложения в кооперации многих команд, разделив систему на части так, чтобы минимизировать зависимость между подсистемами. У нас есть многочисленные техники и методики, полученные на основе огромного опыта создания программных систем, которые объясняют, как именно лучше выделять и отделять предметную область и другие части из системы. Мы умеем так изолировать эти части, что можем менять фреймворки для различных уровней архитектуры, использовать разные универсальные языки программирования (УЯП) и всё это существует вместе, масштабируется, выдерживает большие нагрузки, позволяет выполнять доработку компонентов, не переписывая всю систему. По большей части. Можем, когда хотим.
Прекрасно! Но почему мы до сих пор этого не делаем? Почему так много времени уделяем той части программной составляющей, которая не имеет отношения к предметной области – интерфейсу пользователя, вспомогательным слоям, работе с базой данных и постоянному связыванию этих частей с кодом предметной области в различных фреймворках? Неужели это настолько важно? Почему мы часто начинаем разработку с продумывания интерфейса между компонентами вместо того, чтобы просто писать логику предметной области? Из раза в раз. Уже много лет. Несмотря на технические возможности делать всё правильно.
Это напоминает упорное кодирование на ассемблере используя безусловно хорошие регламенты и инструменты, которые чуток облегчают наше суровое занятие, вместо того чтобы выйти на другой уровень – использовать новые языки и библиотеки, которые позволяют просто писать алгоритмы, не отвлекаясь на работу с устройствами и рутинными операциями.
Скорее всего, проблема кроется в том, что мы привыкли так делать. Существующая индустрия разработки, инструменты, УЯП сверхвысокого уровня, рынки обучения, найма и продвижения достались нам по наследству. А ещё есть страх машинерии, которая должна связывать все наши компоненты и поддерживать масштабирование, из-за которого мы порой забываем об императиве предметной области и превращаем себя в леммингов, занимающихся обслуживанием вспомогательных механизмов.
Всё это – тот монолит, который мы пытаемся масштабировать хотя бы на наше настоящее и надеемся, что будущее придёт и превратит ком грязи в карету. Но так не бывает! Мы сами должны это сделать. Мы и есть будущее!
Пожалуй, довольно пафоса. Давайте попробуем взглянуть на проблему с той стороны, с которой она должна быть рассмотрена, а не с той, с которой мы боимся на неё не смотреть.
Некоторые новые возможности
Первое, что может спросить frontend-разработчик: «где же разработка пользовательского интерфейса»? Впрочем, это касается и остальных компонентов архитектуры: неужели пользователи будут довольствоваться автоматически генерируемыми неотёсанными версиями компонентов вроде интерфейса пользователя и других важных частей, которые вручную можно сделать гораздо более красивыми, удобными и оптимальными?
Конечно нет. В смысле действительно есть возможность на основе «чистой» семантики автоматически генерировать и интерфейс пользователя, и структуру базы данных, но никто не запрещает это делать вручную. Особенно в критических местах. Для этого случая можно дополнить схему разработки из рисунка 1 группой UI-дизайнеров, которые формируют важные элементы пользовательского интерфейса. Однако эти и другие группы желательно размещать под «чистой» семантикой.
Важно заметить, что на рисунке 1 изображена упрощённая схема, которая не отражает многих важных особенностей предлагаемого подхода в разработке ПО. Например, не показано, что может работать несколько DDD-команд, каждая из которых реализует свой ограниченный контекст предметной области. И не отображена возможность автоматизировать не только формирование ИС, но и взаимодействие этих команд, а также интеграцию этого взаимодействия в общем репозитории, баг-трекинге, вики и других инструментах организации разработки сложных программных систем.
Реализация логики
Имея готовые бизнес-сущности и проект бизнес-логики, основанный на интерфейсном скелете, мы можем приступить к реализации задуманного.

И всё-таки
Да, мы стараемся следовать Test-Driven Development (TDD). Это не значит, что мы заставляем каждого разработчика писать код только через TDD и никак иначе. Но мы всецело стараемся использовать TDD в работе.
Поначалу TDD выглядит сложным и непонятным. Но посмотрите, как мастерски управляется Кирилл Толкачёв с реализацией логики приложения при помощи TDD (видео без проблем можно найти в интернете по запросу “Как познавать Spring Boot с помощью TDD”, организаторы JPoint’23 уже выложили все видео конференции в свободный доступ). Менее чем за час доклада рождается готовое приложение, покрытое тестами.
При этом, приложение появляется даже более естественным путём, чем если бы мы сначала написали реализацию, а потом написали тесты – ведь сначала мы понимаем, что мы хотим, и только потом – как это будет реализовано. То же самое происходит и при следовании TDD – мы описываем в тесте, что должна делать функция, а потом пишем в пакете main, как она будет это делать.
Давайте ещё раз.
Test-Driven Development раскрывает первичность замысла. Вначале существует функциональное требование. Потом, силами системного аналитика, оно перерождается в техническое задание. Потом следует техническая реализация (более подробно об этом можно почитать в статье Жизненный цикл задачи: как быстро и бесконфликтно провести задачу от замысла до реализации). На момент написания приложения у нас есть техническое задание, но нет технической реализации. Посредством тестов мы документируем техническое задание (“реализовать сохранение того-то, чтобы в результате оно работало так-то”), и на основании этой документации, мы пишем техническую реализацию в пакете main.
Тесты – это лучшая документация технического задания. Эта документация жива, и постоянно изменяется на протяжении всего жизненного цикла приложения.
Таким образом, читая тесты, мы можем точно понять, какое техническое задание было на момент написания функциональности.
Тут-то и пригодились наши интерфейсы
В своём видео Кирилл Толкачёв опускает этап проектирования приложения. Это можно объяснить задачей доклада – показать простоту разработки через тестирование на реальном примере. Но проект, который приводит в пример Кирилл, подчёркнуто прост, и автор заостряет на этом внимание – например, вместо бизнес-сущности и DTO Кирилл использует String.
Но мы с Вами подготовились, и у нас уже есть:
Наличие этих готовых программных компонентов ещё более упростит задачу, и реализация приложения через TDD будет проще, чем показал Кирилл.
Реализуйте интерфейсы, начиная от самых независимых. Мы реализуем интерфейсы с разрешёнными зависимостями. Для интерфейсов без зависимостей нет разрешённых зависимостей. Когда мы реализуем их, мы поднимемся выше и реализуем интерфейсы, которые зависят от интерфейсов первой очереди.
В нашем случае, независимыми интерфейсами являются GoodService и PaymentService. С них и начнём. Дальше, реализуем CartService и PaymentService. Закончим CustomerService.
Приступим. Начнём с GoodService.

Мы сразу видим, что тест упадёт – у нас попросту нет реализации GoodService. Но такой тест уже хотя бы скомпилируется. Важно, что мы написали тест целиком – нам не придётся его править по итогам реализации тестируемой функции.
Следующим шагом будет реализация самой функции, но прежде нам предстоит ответить на вопрос на миллион.
Как на этом этапе быть с DAO?
Мы подошли к очень важному шагу: впереди реализация сервисной функции. Но сервисные функции редко работают сами с собой – они или запрашивают данные, или работают с состоянием сущности. Иными словами, они работают с DAO. Та же функция create, как уже понятно из названия, создаёт новый экземпляр сущности. И, весьма вероятно, где-то его сохранит. В нашем случае, в базе данных.
На этот вопрос есть неудобный ответ. Мы не реализуем DAO на этапе реализации логики. Реализация внешних интерфейсов может потребовать значительного погружения в их предметную область и особенности API, поэтому мы быстро пишем мок и идём дальше. И варианта тут два:
Я рекомендую выбирать подход, исходя из дальнейших планов на тесты. Если Вы планируете инкапсулировать тесты в рамках своего слоя (сервисные тесты проверяют только логику и не сохраняют в базу, контроллерные тесты не ходят в сервис и проверяют только путь и параметры), тогда возьмите вариант 1. Если же Вы планируете сделать упор на сценарных тестах, с тестированием всего сценария, от контроллера до репозитория и обратно, ваш вариант – 2.
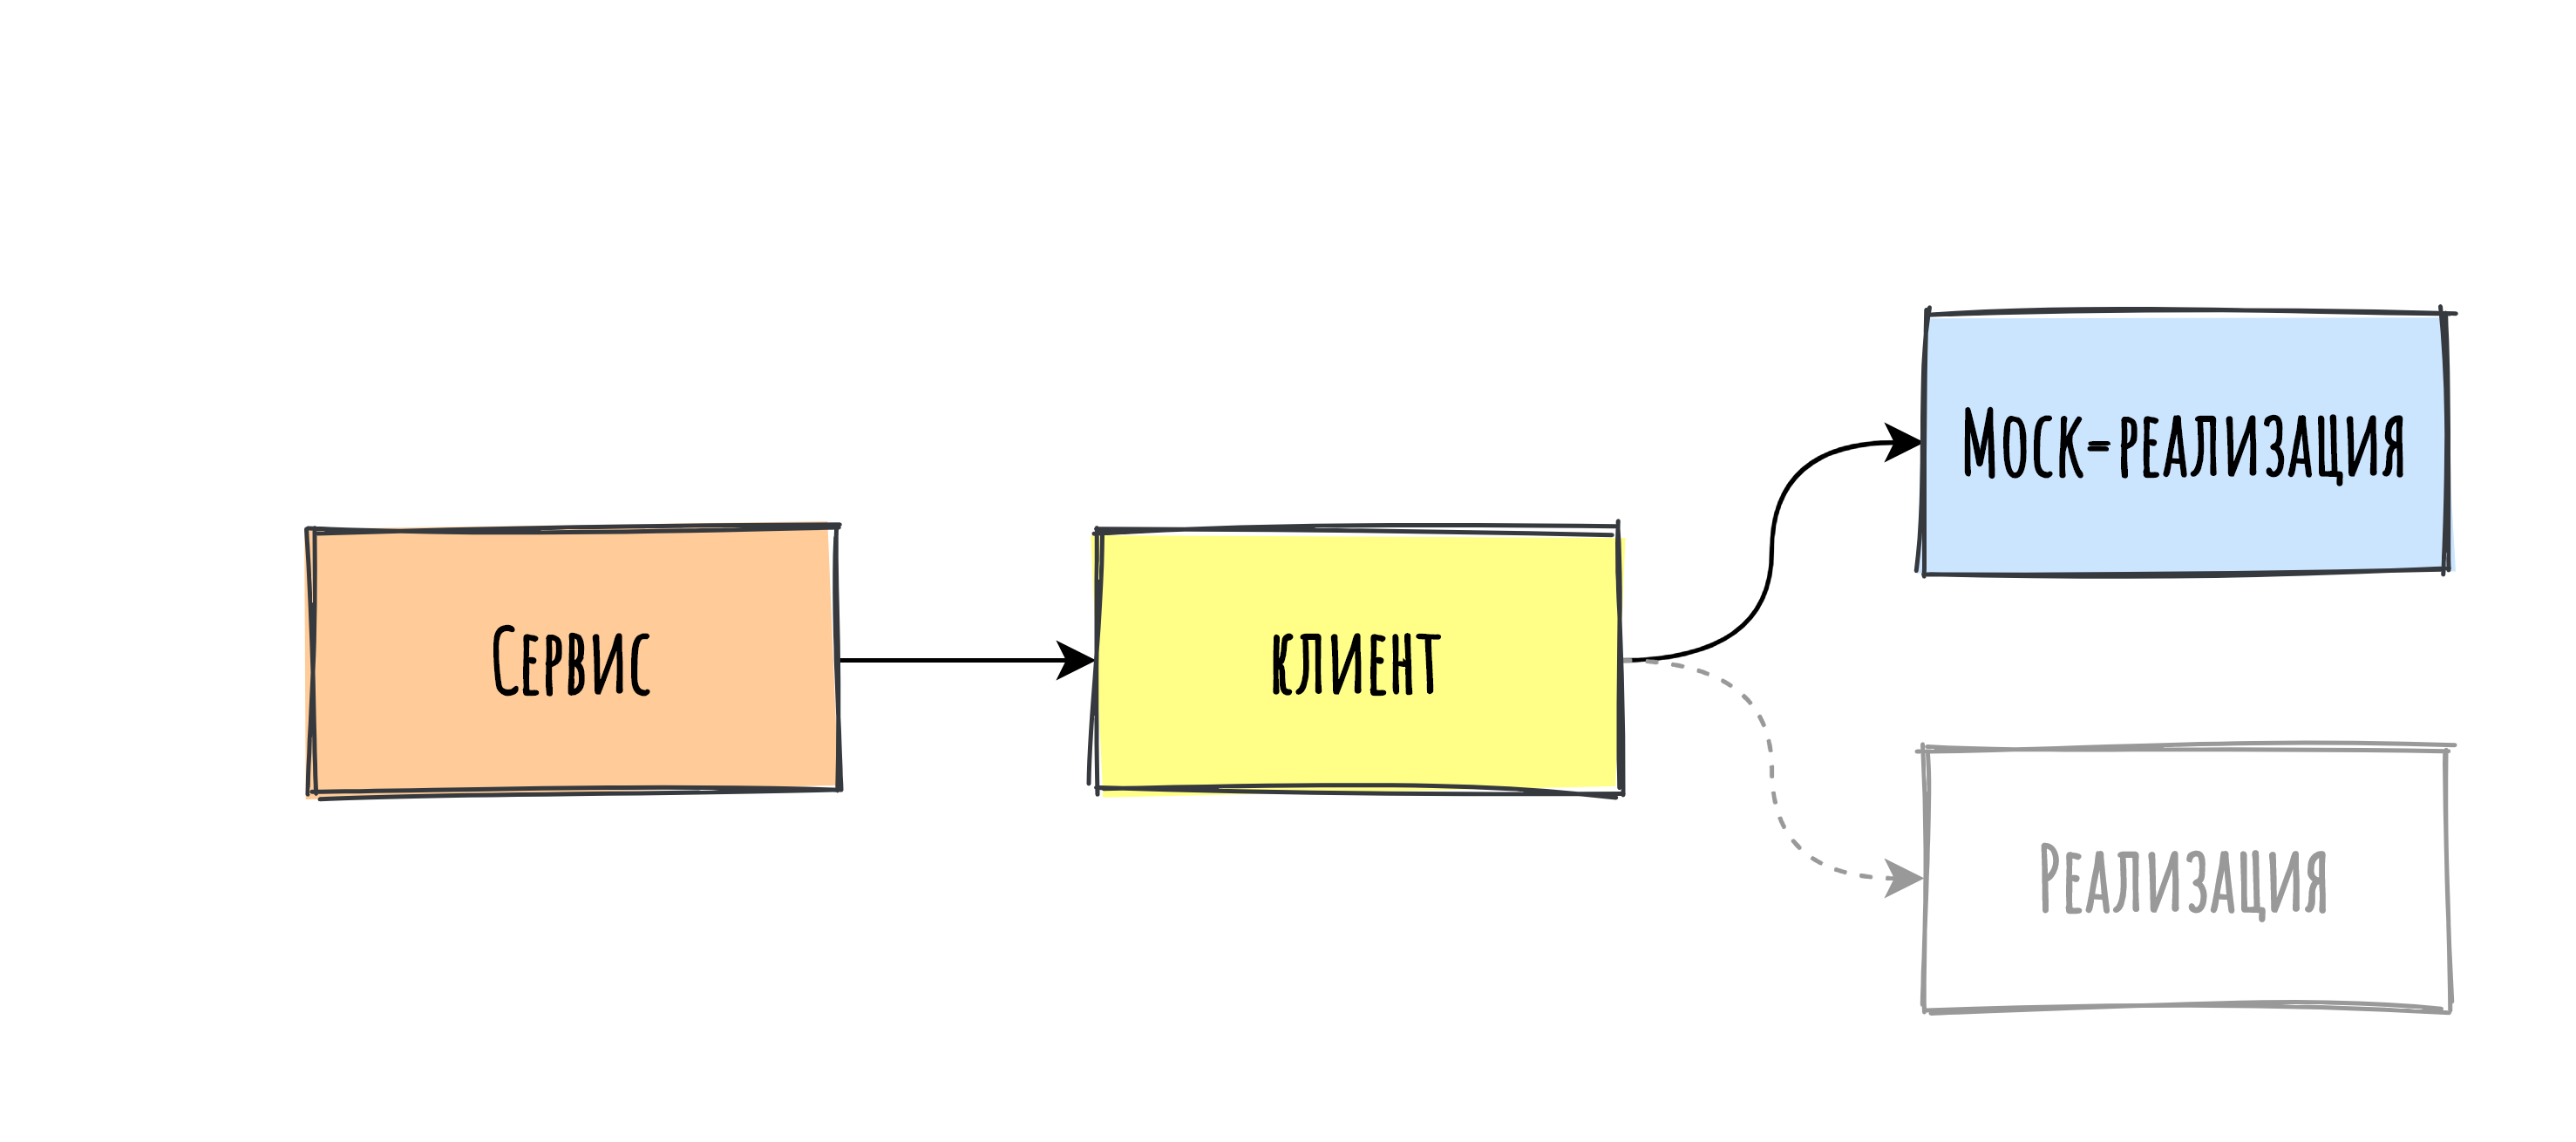
Лично я предпочитаю сценарные. Я воспринимаю выполнение функции как работу всех функций, которые она вызывает. Если такая функция вызывает приватную функцию, происходит тестовое покрытие приватной функции. Если вызывает функцию DAO, значит, функция DAO является частью работы той функции, которая её вызывает, и тоже должна быть проверена в составе единого целого.
И, что немало важно, благодаря нашей подготовке в части шагов 1 и 2, второй вариант не будет слишком дорогим. Создавая интерфейсы и мокая их, мы попутно проектируем слой DAO, закладывая, таким образом, фундамент для четвёртого шага. Слой DAO будет спроектирован исходя из потребностей логического слоя, в нём будет ровно необходимое количество функций, и Вы избежите риска чего-нибудь наоверинжинирить.
Именно этот подход мы и возьмём в качестве примера.
Итак, для сохранения товара нам необходимо сохранить его состояние в базе данных. Значит, нам необходим интерфейс GoodRepository. Создадим такой интерфейс с единственной функцией save.
Мы помним, что согласно TDD, нужно писать только то количество кода, которое необходимо для успешного прохождения теста, так что, наличие единственной функции save нас вполне устроит.
Далее, мы пишем мок-реализацию для функции сохранения товара в базе данных. Это вряд ли займёт больше минуты.
Далее, пишем реализацию. Ещё 30 секунд:
Ура. Тест прошёл.
А как быть с реализацией функции, для которой уже есть DAO-клиент?
Вышеописанный рецепт хорошо подходит для этапа первоначальной разработки приложения, но мы используем данный подход и для зрелых приложений, при реализации фич. И вполне вероятна ситуация, когда в приложении уже есть рабочий компонент DAO.
Если слой DAO уже есть, и он работает, принимайте решение исходя из реалий тестирования. Если это, предположим, база данных, которую Вы тестируете через testcontainers, то проще сразу написать этот запрос. Для клиентов, которые Вы и так мокаете при тестировании, ничего не меняется – Вы так же пишете мок для тестов, а на четвёртом этапе пишете реализацию.
Итак, мы закончили третий этап. В итоге, у нас получается приложение, которое всё умеет, но ничего не видит, ничего не слышит, ничего не рассказывает. Базовые умения реализованы, но приложение не имеет фактических выходов вовне. Дать эти выходы – задача заключительного, четвёртого, этапа.
Проектирование предметной области

Любое приложение существует в особом предметном мире, который создаём мы, разработчики. Ключевые элементы этого мира мы получаем от бизнес-аналитиков. Их задача – дать наиболее полную информацию об этом мире. Наша задача – спроектировать этот мир через бизнес-сущности.
Бизнес-сущности ничего не умеют делать. Их поведение ограничивается обслуживанием самих себя. Они не знают ни про что, кроме как про себя и про другие такие же бизнес-сущности. Они полностью беспомощны. Они просто существуют и всё. Их единственная задача – наполнять своим существованием предметную область приложения.
Почти сферические бизнес-сущности в почти вакууме. Спасибо Kandinsky 2.2
Нам, как разработчикам, нужно спроектировать основные бизнес-сущности и частично второстепенные. Конечно, по мере развития приложения бизнес-сущностей будет становиться больше, но на первом этапе нам будет достаточно тех сущностей, которые появятся на основе первых бизнес-требований.
Зачем нам нужен этот шаг, и почему он должен быть первым?
Создавая предметную область, мы отвечаем на главный вопрос: зачем нам нужен тот или иной сервис? Каковы границы его обязанностей? Какова его задача в общей архитектуре? Возможно, в какой-то момент Вы поймёте, что Ваш сервис дублирует функциональность другого сервиса и избыточен. Или он призван делать слишком много разных задач, и его лучше разбить на несколько микросервисов.
Ответы на все эти вопросы будут получены на этапе познания предметной области, и очень важно, чтобы этот этап был не только самым первым, но и не успел обрасти логикой, которую потом будет очень сложно выделить / удалить.
Поэтому этот этап так важен, и важно пройти его в самом начале.
Также, как уже было отмечено ранее, бизнес-сущности являются ядром луковичной архитектуры и ни от чего не зависят. Их описание в коде даёт основу для следующего “луковичного” слоя – Вы просто не сможете написать сервисный слой, не имея бизнес-сущностей.
На этап проектирования предметной области обычно уходит несколько дней, и он включает в себя три шага:
На данном проекте, не надо подключать никакие сторонние библиотеки, кроме, пожалуй, Spring Web Starter. Наш проект должен просто стартовать, и всё. Брокеры сообщений, конфигурации подключения к базе данных, сериализаторы / десериализаторы нам не нужны. Всё, что нам нужно – это стандартный языковой пакет. Ведь наши бизнес-сущности ничего не умеют, а для их описания достаточно стандартной библиотеки.
Этап 1A. Описываем предметную область
Давайте потренируемся на примере интернет-магазина.
Нас взяли в команду, которая будет писать интернет-магазин. Интернет-магазин – это заказы, покупатели, платежи, доставка. Конечно, предметная область интернет-магазина намного шире даже на первоначальном этапе, и я уверен, что вы справитесь с детальным проектированием этой предметной области, но для удобства мы значительно её упростим.
Нам необходимо описать основные бизнес-сущности и связи между ними.
Главную сущность в интернет-магазине мы определим как “Товар” (Good). Без, собственно, товара не может быть ни Заказа в привычном понимании, ни Покупателя, ни Платежа, ни всего остального. Все остальные сущности так и или иначе, прямо или косвенно, связаны с товаром.
На один Товар может быть несколько Заказов (Order). В одном Заказе может быть много товаров. Many-To-Many.
У одного Товара может быть несколько покупателей, но зачем нам на данном этапе лишняя связь? Мы свяжем Товар с Покупателем (Customer) через Заказ. У одного Заказа может быть один Покупатель. У одного Покупателя может быть много Заказов. One-To-Many.
У одного Заказа может быть много платежей (например, первый платёж может по каким-то причинам не пройти, и тогда будет создан новый, или Покупатель использовал популярный сплит). Связь Заказ – Оплата (Payment). One-To-Many.
Да, Корзина (Cart). Корзина связана как с Покупателем, так и с Товаром. В Корзине может быть много Товаров, Товар может быть в разных Корзинах. Many-To-Many. У Покупателя может быть только одна Корзина. One-To-One.
Я не являюсь большим специалистом по проектированию предметной области интернет-магазинов, поэтому бизнес-сущности будут условными.
Этап 1B. Визуализируем
Вы можете сказать: давайте без визуализации, и так всё понятно. Но поверьте: лучший способ утрясти предметную область в голове – это сесть и нарисовать эту диаграмму. Потраченные полдня сэкономят существенно больше.
Итак, на первоначальном этапе, интернет-магазин будет визуализирован следующим образом:
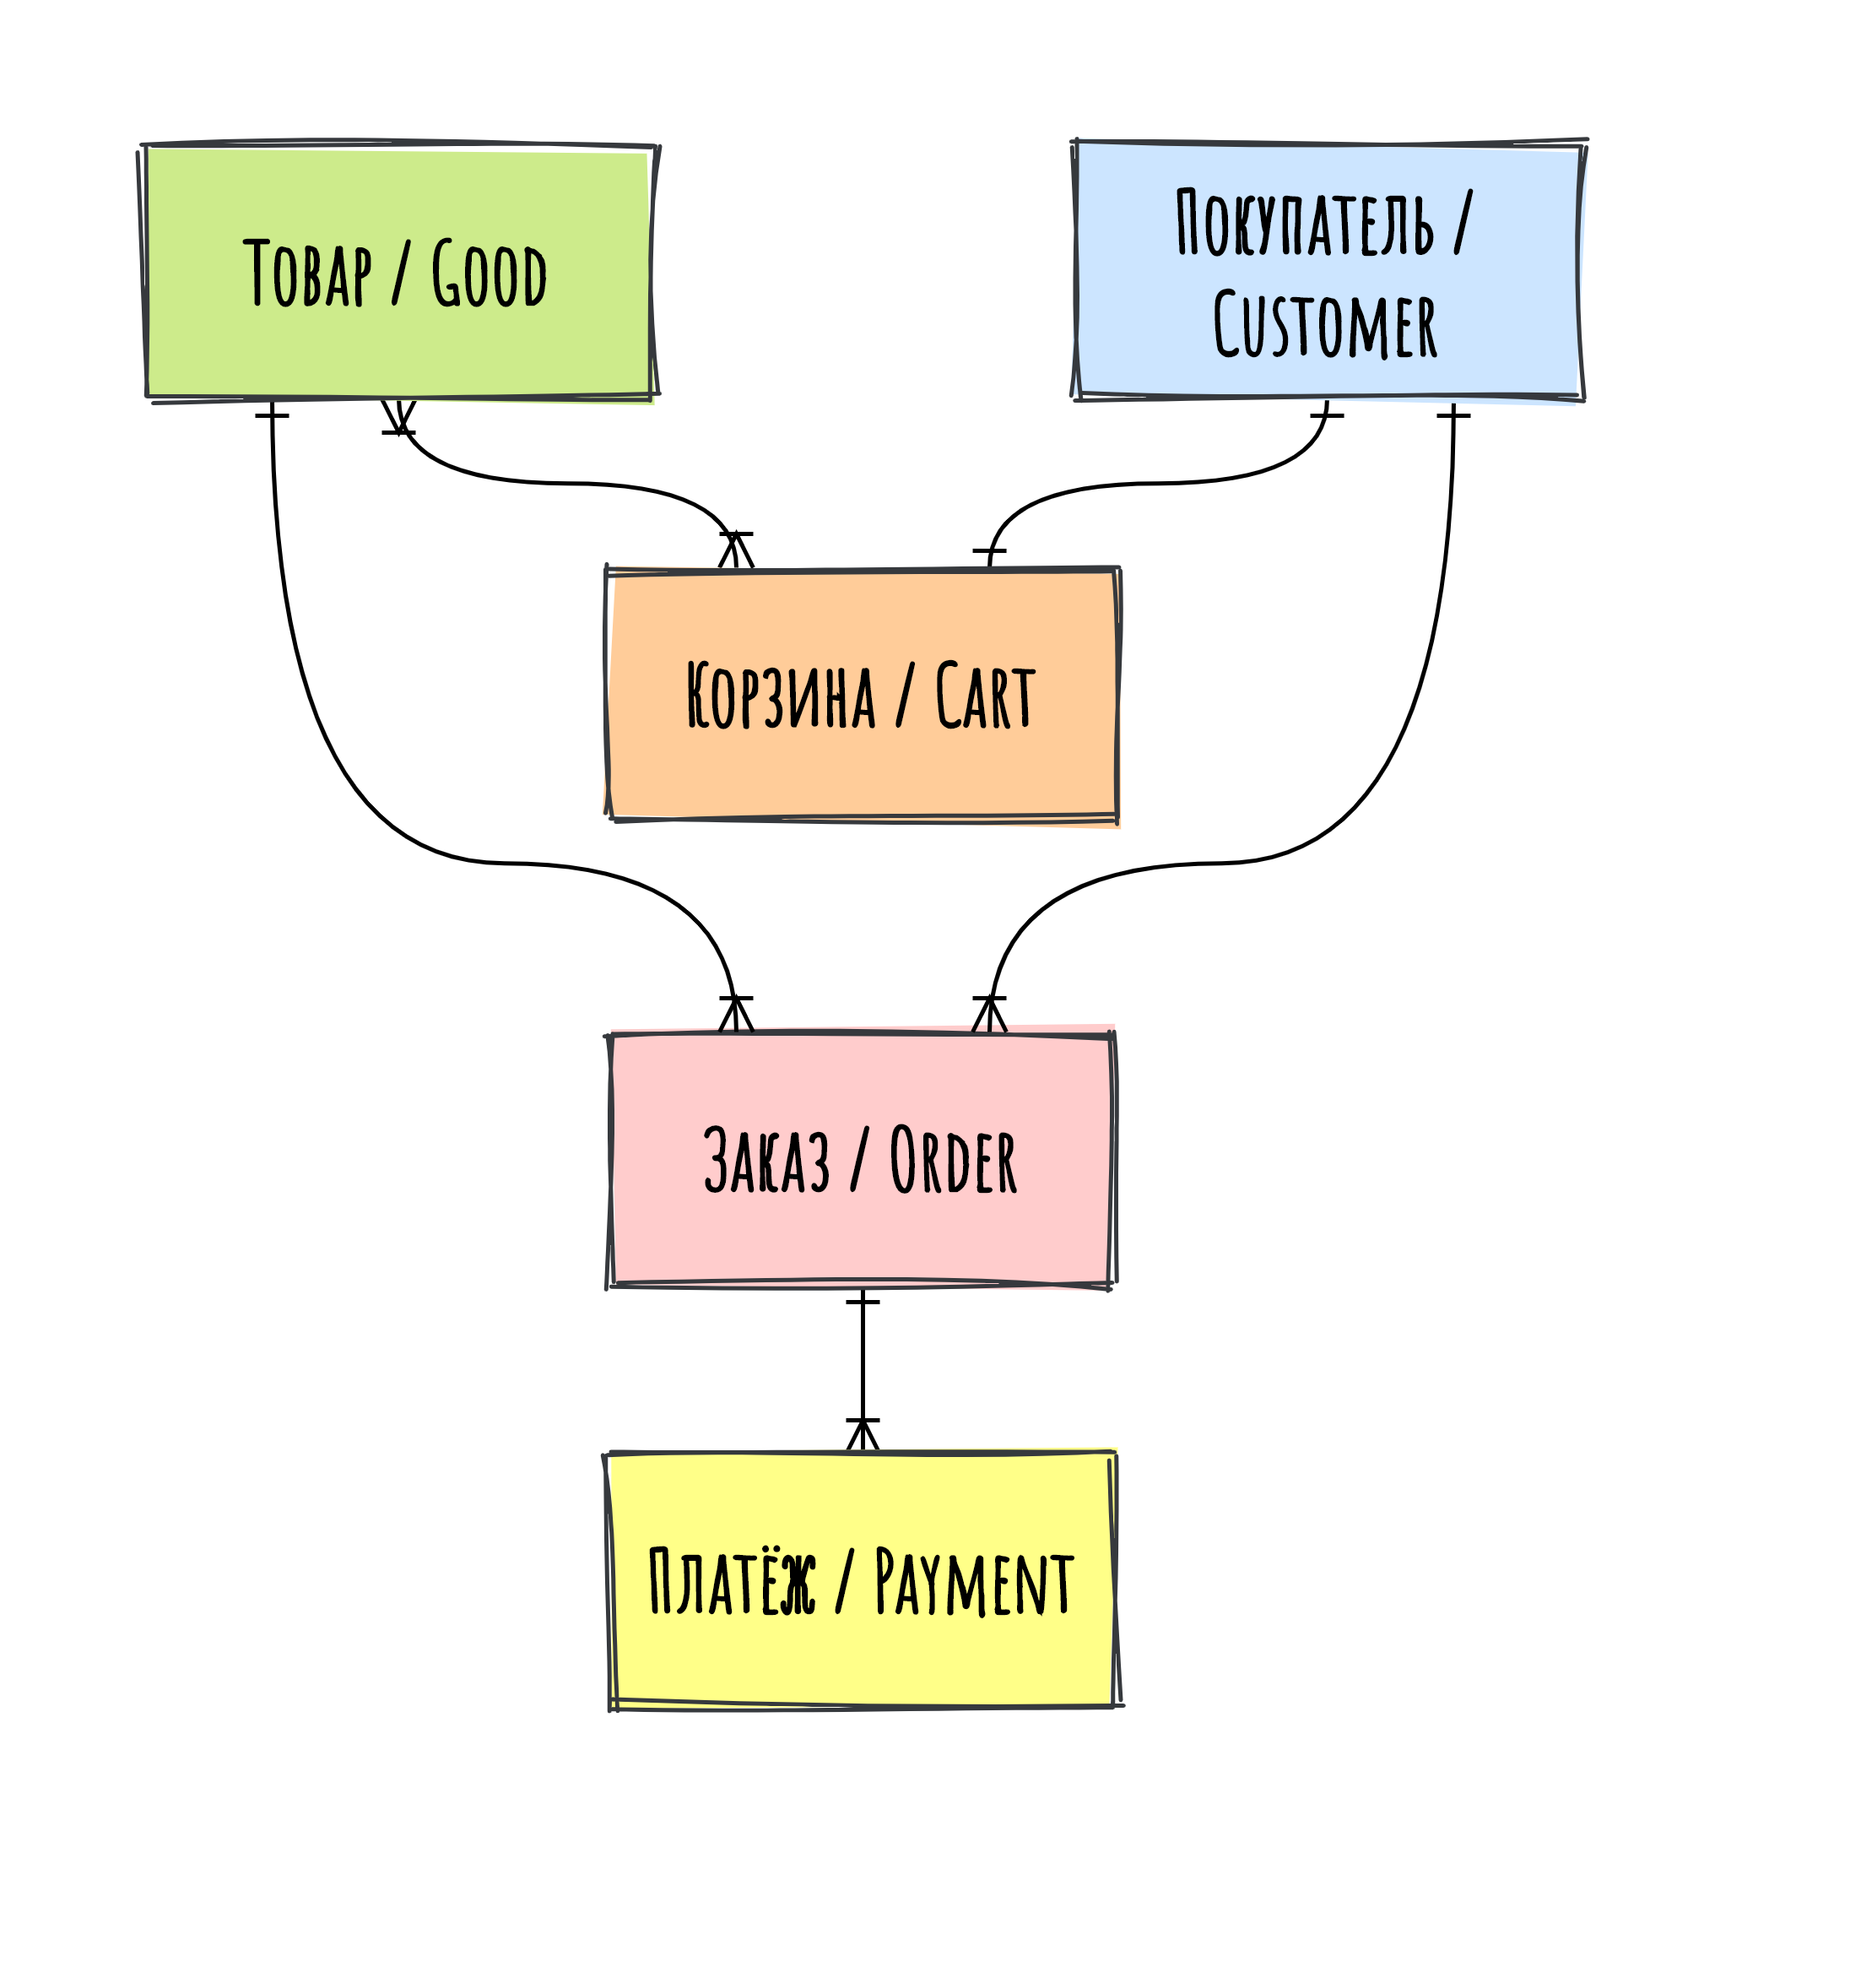
Простейший пример визуализации бизнес-сущностей интернет-магазина.
Наш пример максимально прост. В реальной жизни предметная область будет изобиловать десятками бизнес-сущностей. Это нормально.
Приложение от проекта до релиза
С чего начинать писать новое приложение? Когда приложение должно заработать? Когда оно должно быть покрыто тестами? Зачем использовать интерфейсы? Что важнее – бизнес-сущность или табличка в базе данных?
Очень часто, приходя в команду, я вижу, как уважаемые коллеги путают этапы реализации: некоторые этапы пропускают, некоторые выполняют раньше положенного. Приложение обрастает связями, становится менее гибким и начинает задыхаться от архитектурных проблем, заложенных на старте, от которых не может избавиться до самого последнего дня эксплуатации.
Такое приложение можно сравнить с атлетом, который бежит марафон со сбитым дыханием – его преждевременная остановка задолго до конца маршрута является делом времени.
Меня зовут Вячеслав, я разработчик в Сбере. До Сбера я работал в стартапе, потом в хорошей компании средней руки, потом на галере и в IT-дочке госкорпорации. Поэтому предложенный ниже рецепт я могу подкрепить самым разнообразным личным опытом.
В статье ниже мы разберём основные этапы разработки приложения, их детали и особенности.
Я выделяю 4 основных этапа разработки приложения:
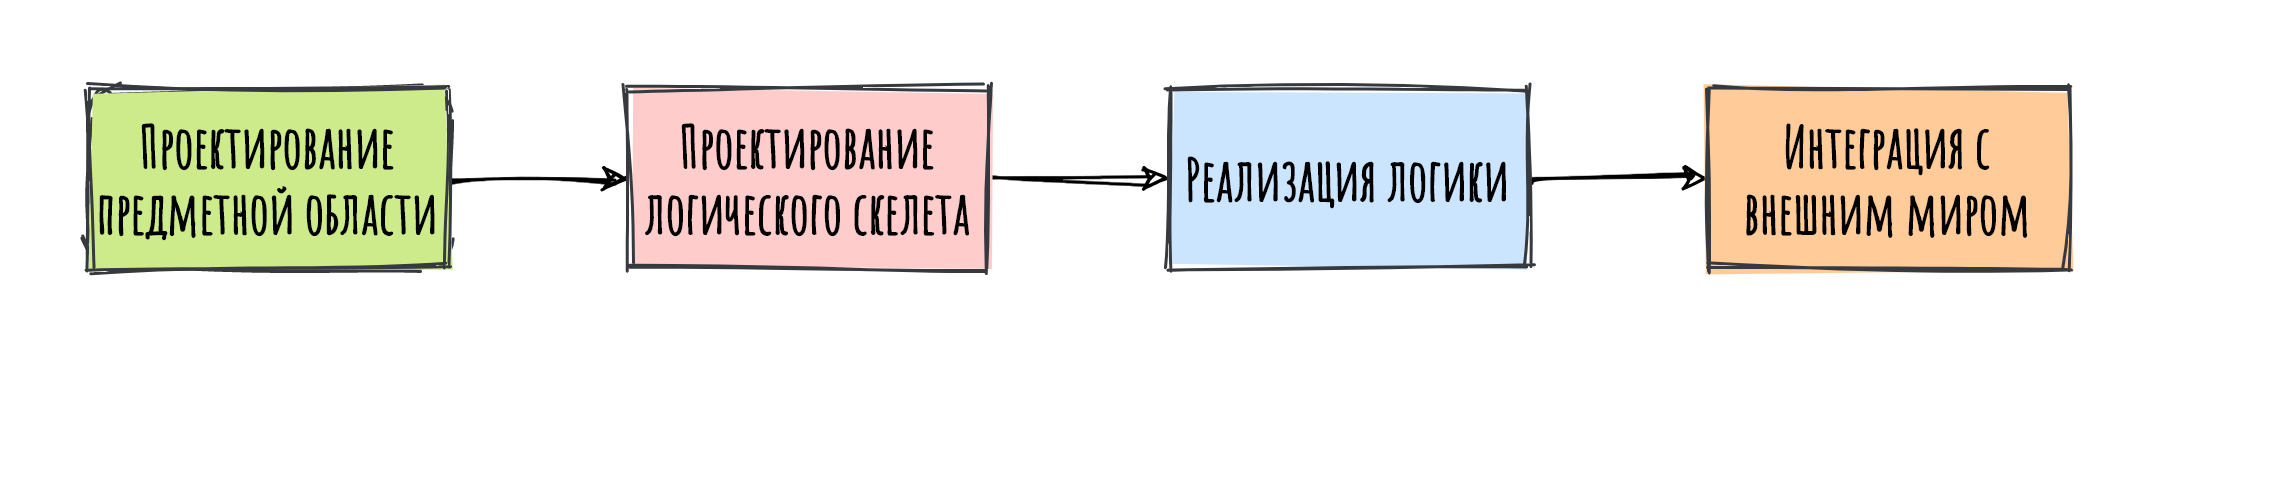
Да, эти этапы и их очерёдность являются прямым следствием “луковичной архитектуры”.
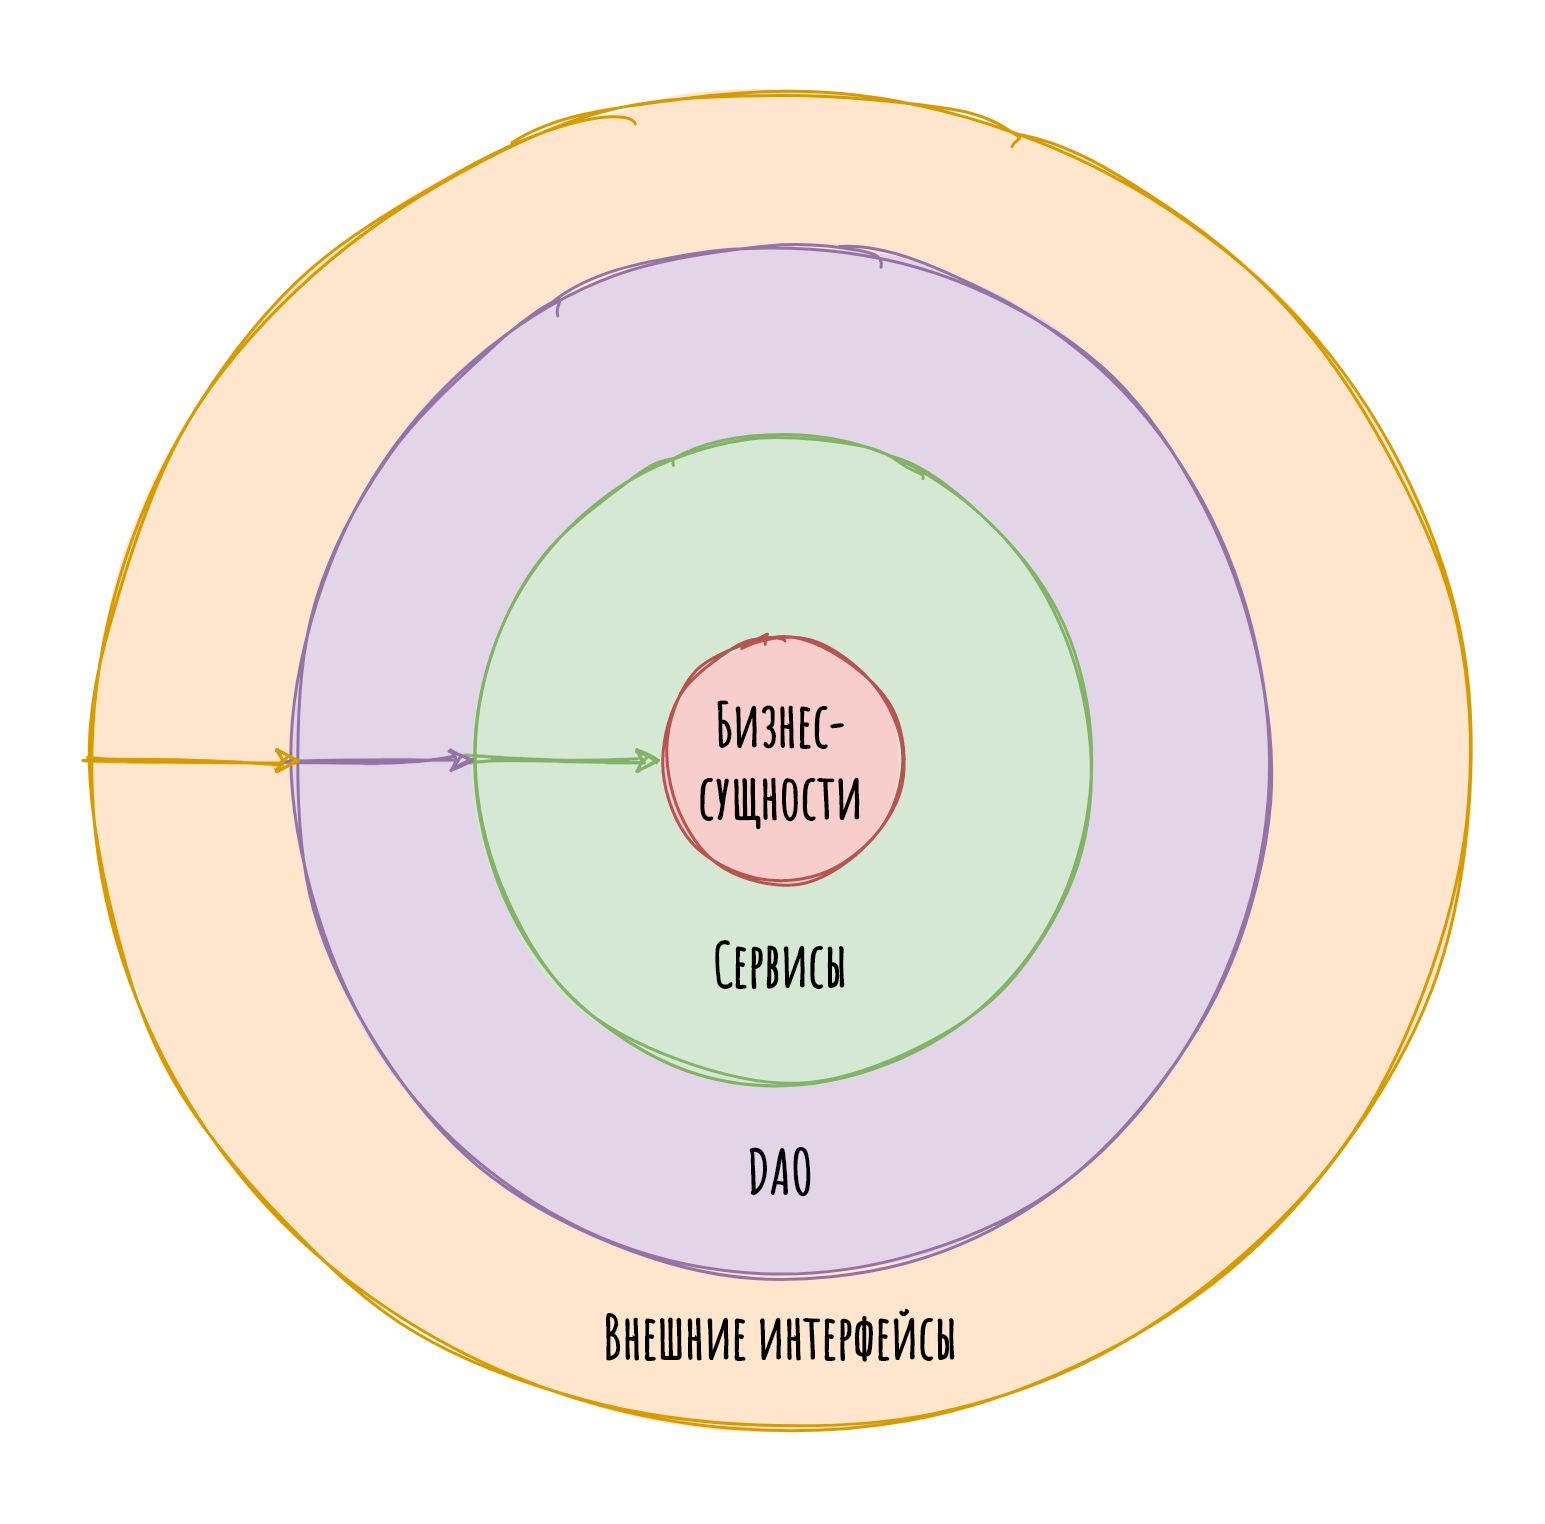
В “луковичной архитектуре” ключевым программным компонентом является бизнес-сущность. Слой бизнес-сущностей окружён сервисным слоем, в котором описано поведение бизнес-сущностей. Далее следует слой Data Access Object – клиенты для подключения к внешним интерфейсам (база данных, сторонние сервисы, брокеры сообщений). За пределами DAO располагаются, собственно, внешние интерфейсы, которые уже не являются частями приложения.
Уверен, Вы уже достаточно знаете про “луковичную” архитектуру. Если не знаете, или, к примеру, позабыли, рекомендую к прочтению статью Луковичная архитектура в компоновке backend-приложения и куда в итоге класть маперы, написанную около года назад Вашим покорным слугой.
Наверняка, первый вопрос, который Вам захочется задать, будет:
Нет, уважаемые коллеги. Если ответственно подойти к делу, и при наличии готовой внятной аналитики, на первую, самую трудозатратную, итерацию уйдёт приблизительно один спринт.
После этого небольшого отступления, приступим к разбору первого этапа реализации приложения – проектированию предметной области.
Заключение
Предлагаемый подход обеспечивает кардинальную изоляцию предметной области от архитектуры и инфраструктуры разрабатываемой информационной системы, что должно позволить выбирать или менять компоненты архитектуры и инфраструктуры с минимальным влиянием на автоматизируемую предметную область. Также при использовании данного подхода, должно существенно сократиться не только время разработки, но и количество разработчиков на УЯП. А это значит, что разработка будет стоить значительно дешевле, чем при существующих подходах.
Одним из решений, предлагаемых для реализации данного подхода, является создание инструмента, автоматизирующего разработку языков для предметных областей, в том числе для DDD, как предметной области автоматизации предметных областей. Такой инструмент в настоящее время разрабатывается на кафедре ИУ6 МГТУ им. Н.Э. Баумана.

Вы начали реализовывать приложение. Описали предметную область. Определили логику. Написали тесты. Реализовали интеграцию.
Вышеописанный рецепт отлично работает не только в масштабе написания приложения, но и в масштабе реализации новой фичи.
Вы получили функциональные требования. Освежите бизнес-сущности (если надо). Напишите интерфейсы поведения (если появились новые сущности) или допишите необходимые функции к старым. Напишите тесты, реализуйте заложенные в них технические требования. Реализуйте интеграцию.
Следуйте этому рецепту, и в Вашей работе будет больше порядка.